El sistema de archivos (File System) es una gran colección de directorios y archivos que guardan todo tipo de información. En sistemas de muchos usuarios se pueden tener cientos o miles de archivos.
La mayoría de los sistemas operativos manejan su propio sistema de archivos.
Windows: Soporta FAT, FAT12, FAT16, FAT32, NTFS, exFAT y ReFS Linux: Soporta ext2, ext3 y ext4, XFS, JSF, ReiserFS y btrfs
A continuación se explicarán brevemente los sistemas de archivos:
FAT12: Es un sistema de archivos para disquete. No soporta anidación de carpeta. Las direcciones de bloque solamente contienen 12 bits. El tamaño del disco se almacena como una cuenta de 16 bits expresada en sectores, lo que limita el espacio manejable a 32 megabytes.
FAT16: El tamaño de la partición ahora estaba limitado por la cuenta de sectores por clúster, que era de 8 bits. Esto obligaba a usar clusters de 32 Kbytes con los usuales 512 bytes por sector. Así que el límite definitivo de FAT16 se situó en los 2 gigabytes.
FAT32: Se utilizan direcciones de cluster de 32 bits. En teoría, esto debería permitir aproximadamente tamaños de almacenamiento cercanos a los ocho terabytes. Sin embargo, debido a limitaciones en la utilidad ScanDisk de Microsoft, no se permite que FAT32 crezca más allá de 4.177.920 clusters por partición (es decir, unos 124 gigabytes). Posteriormente, Windows 2000 y XP situaron el límite de FAT32 en los 32 gigabytes. El tamaño máximo de un archivo en FAT32 es 4 gigabytes.
exFAT: Permite utilizar archivos de más de 4 gigabytes.
NTFS: Permite definir el tamaño del clúster, a partir de 512 bytes (tamaño mínimo de un sector) de forma independiente al tamaño de la partición. Es un sistema adecuado para las particiones de gran tamaño requeridas en estaciones de trabajo de alto rendimiento y servidores puede manejar volúmenes de, teóricamente, hasta 2^64–1 clústeres. En la práctica, el máximo volumen NTFS soportado es de 2^32–1 clústeres (aproximadamente 16 TiB usando clústeres de 4 KiB).
Su principal inconveniente es que necesita para sí mismo una buena cantidad de espacio en disco duro, por lo que no es recomendable su uso en discos con menos de 400 MiB libres.
ext2: Los límites son un máximo de 2 terabytes de archivo, y de 4 para la partición.
ext3: Tiene la ventaja de permitir actualizar de ext2 a ext3 sin perder los datos almacenados ni tener que formatear el disco. Tiene un menor consumo de CPU y está considerado más seguro que otros sistemas de ficheros en Linux dada su relativa sencillez y su mayor tiempo de prueba.
ext4: Las principales mejoras son: Soporte de volúmenes de hasta 1024 PiB. Soporte añadido de extent. Menor uso del CPU. Mejoras en la velocidad de lectura y escritura.
XFS: Sistema de archivos de 64 bits con journaling de alto rendimiento creado por SGI. Soporta un sistema de archivos de hasta 9 exabytes, aunque esto puede variar dependiendo de los límites impuestos por el sistema operativo. En sistemas GNU/Linux de 32 bits, el límite es 16 terabytes.
JFS: Sistema de archivos de 64-bit con respaldo de transacciones creado por IBM. Tiene una dimensión máxima de archivo de 4PiB y un tamaño máximo de volumen de 32Pi.
Btrfs: Sistema de archivos copy-on-write, anunciado por Oracle para GNU/Linux. Tiene una dimensión máxima de archivo de 16EiB y una dimensión de volument máxima de 16EiB. Copy on wirte permite crear una copia de un recursos cuando es solicitado por varios procesos, evitando asi que uno modifique la información utilizada por otro
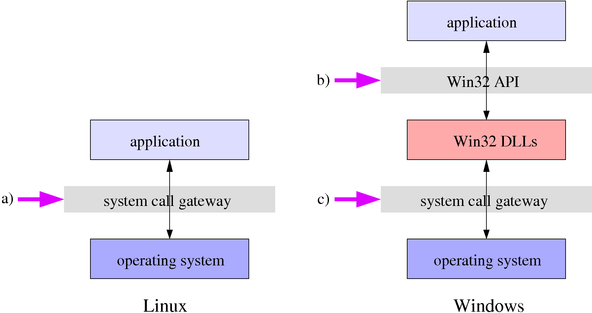
En el mundo Windows en general, las llamadas al sistema se denominan API (Windows application programming interface), es un conjunto de funciones residentes en bibliotecas (generalmente dinámicas, también llamadas DLL por sus siglas en inglés, término usado para referirse a éstas en Windows) que permiten que una aplicación corra bajo un determinado sistema operativo. Por ejemplo, Windows proporciona una función denominada FlashWindowEx que permite que la barra de título de una aplicación alterne entre un sombreado claro y otro oscuro.
Las funciones API se dividen en varias categorías:
Depuración y manejo de errores
E/S de dispositivos
Varias DLL, procesos e hilos
Comunicación entre procesos
Manejo de la memoria
Monitoreo del desempeño
Manejo de energía
Almacenamiento
Información del sistema
GDI (interfaz para dispositivos gráficos) de Windows (tales como impresoras)
Interfaz de usuario de Windows
La ventaja de utilizar las API de Windows en el código es que pueden ahorrar tiempo porque contienen numerosas funciones útiles ya escritas y listas para utilizar.
La desventaja es que puede resultar difícil trabajar con las API de Windows y pueden ser implacables cuando las cosas van mal.
Las API de Windows representan una categoría especial de interoperabilidad. Las API de Windows no utilizan código administrado, no tienen bibliotecas de tipos integradas y utilizan tipos de datos que son diferentes a los que se utilizan en Visual Studio. Debido a estas diferencias y a que las API de Windows no son objetos COM, la interoperabilidad con las API de Windows y .NET Framework se lleva a cabo mediante la invocación de la plataforma o PInvoke. Invocación de la plataforma es un servicio que permite al código administrado llamar a funciones no administradas implementadas en archivos DLL.
Las llamadas a las API de Windows constituían en el pasado un parte importante de la programación de Visual Basic, pero en Visual Basic 2005 pocas veces resultan necesarias. Siempre que sea posible, debe utilizar código administrado en .NET Framework para llevar a cabo tareas en lugar de utilizar llamadas a las API de Windows.
Para mas información visite: Tutorial: Llamar a las API de Windows __________________________ Fuente: http://msdn.microsoft.com/es-es/library/172wfck9%28v=vs.80%29.aspx Fuente: http://es.wikipedia.org/wiki/API_de_Windows
Un proceso es cualquier programa en ejecución. este necesita ciertos recursos para realizar satisfactoriamente su tarea:
Tiempo de CPU.
Memoria.
Archivos.
Dispositivos de E/S.
Las obligaciones del SO como gestor de procesos son:
Creación y eliminación de procesos.
Planificación de procesos (procurando la ejecución de múltiples procesos maximizando la utilización del procesador).
Establecimiento de mecanismos para la sincronización y comunicación de procesos.
Manejo de bloqueos mutuos.
Estados de un proceso
A medida que un proceso se ejecuta cambia de estado. Cada proceso puede estar en uno de los estados:
Nuevo (new): el proceso se está creando.
En ejecución (running): el proceso está en la CPU ejecutando instrucciones.
Bloqueado (waiting, en espera): proceso esperando a que ocurra un suceso (ej. terminación de E/S o recepción de una señal).
Preparado (ready, listo): esperando que se le asigne a un procesador.
Terminado (terminated): finalizó su ejecución, por tanto no ejecuta más instrucciones y el SO le retirará los recursos que consume.
Nota: Sólo un proceso puede estar ejecutándose en cualquier procesador en un instante dado, pero muchos procesos pueden estar listos y esperando.
Diagrama de estados de un proceso
Para que un programa se ejecute, el SO debe crear un proceso para él. En un sistema con multiprogramación el procesador ejecuta código de distintos programas que pertenecen a distintos procesos.
Aunque dos procesos estén asociados al mismo programa, se consideran dos secuencias de ejecución separadas, cada una de las cuales se considera un proceso.
Llamamos traza de un proceso al listado de la secuencia de instrucciones que se ejecutan para el mismo.
Creación de Procesos
los procesos se crean mediante una llamada al sistema de “crear proceso”, durante el curso de su ejecución. El proceso creador se denomina proceso padre, y el nuevo proceso, hijo.
Cuando un proceso crea un proceso nuevo, hay dos posibilidades en términos de ejecución:
Padre e hijo se ejecutan concurrentemente.
Padre espera por la finalización del hijo.
En UNIX existen dos funciones básicas para crear procesos: Fork y Exec.
Función fork():Cuando se la llama crea un proceso hijo que es una copia casi exacta del proceso padre (duplicado del padre). Ambos procesos continúan ejecutándose desde el punto en el que se hizo la llamada a fork().
En UNIX los procesos se identifican mediante un “identificador de proceso” (PID) que es un entero único. Ambos procesos continúan su ejecución con la instrucción que sigue al fork() con una diferencia:
El código que el hijo recibe del fork es cero.
El que recibe del padre es el propio pid.
Funciones exec: Tras crear un nuevo proceso, después de llamar a fork, Linux llama a una función de la familia exec. Éstas funciones reemplazan el programa ejecutándose en el proceso por otro programa. Cuando un programa llama a una función exec, su ejecución cesa de inmediato y comienza a ejecutar el nuevo programa desde el principio, suponiendo que no ocurriera ningún error durante la llamada.
Generalmente uno de los dos procesos (padre o hijo) utiliza la llamada al sistema exec ve después del fork para reemplazar su espacio de memoria con un programa nuevo.
Nota: Si el padre no tiene nada que hacer mientras el hijo se ejecuta, puede emitir una llamada wait (esperar) para sacarse a sí mismo de la cola de procesos listos hasta que el hijo termine.
HILOS (threads)
Los hilos son un concepto relativamente nuevo de los SO. En este contexto, un proceso recibe el nombre de proceso pesado, mientras que un hilo recibe el nombre de proceso ligero. El término hilo se refiere sintáctica y semánticamente a hilos de ejecución.
El término multihilo hace referencia a la capacidad de un SO para mantener varios hilos de ejecución dentro del mismo proceso.
En un SO con procesos monohilo (un solo hilo de ejecución por proceso), en el que no existe el concepto de hilo, la representación de un proceso incluye su PCB, un espacio de direcciones del proceso, una pila de proceso y una pila núcleo.
En un SO con procesos multihilo, sólo hay un PCB y un espacio de direcciones asociados al proceso, sin embargo, ahora hay pilas separadas para cada hilo y bloques de control para cada hilo.
Estructura de los Hilos
Un hilo (proceso ligero) es una unidad básica de utilización de la CPU, y consiste en un contador de programa, un juego de registros y un espacio de pila.
Los hilos dentro de una misma aplicación comparten:
La sección de código.
La sección de datos.
Los recursos del SO (archivos abiertos y señales).
Un proceso tradicional o pesado es igual a una tarea con un solo hilo.
Los hilos permiten la ejecución concurrente de varias secuencias de instrucciones asociadas a diferentes funciones dentro de un mismo proceso, compartiendo un mismo espacio de direcciones y las mismas estructuras de datos del núcleo.
Estados de un Hilo
Los principales estados de un hilo son: ejecución, preparado y bloqueado; y hay cuatro operaciones básicas relacionadas con el cambio de estado de los hilos:
Creación: En general, cuando se crea un nuevo proceso se crea también un hilo para ese proceso. Posteriormente, ese hilo puede crear nuevos hilos dándoles un puntero de instrucción y algunos argumentos. Ese hilo se colocará en la cola de preparados.
Bloqueo: Cuando un hilo debe esperar por un suceso, se le bloquea guardando sus registros. Así el procesador pasará a ejecutar otro hilo preparado.
Desbloqueo: Cuando se produce el suceso por el que un hilo se bloqueó pasa a la cola de listos.
Terminación: Cuando un hilo finaliza, se liberan su contexto y sus pilas.
Un punto importante es la posibilidad de que el bloqueo de un hilo lleve al bloqueo de todo el proceso. Es decir, que el bloqueo de un hilo lleve al bloqueo de todos los hilos que lo componen, aún cuando el proceso está preparado.
Recursos compartidos y no compartidos
Los hilos permiten la ejecución concurrente de varias secuencias de instrucciones asociadas a diferentes funciones dentro de un mismo proceso, compartiendo un mismo espacio de direcciones y las mismas estructuras de datos del núcleo.
Recursos compartidos entre los hilos:
Código (instrucciones).
Variables globales.
Ficheros y dispositivos abiertos.
Recursos no compartidos entre los hilos:
Contador del programa (cada hilo puede ejecutar una sección distinta de código).
Registros de CPU.
Pila para las variables locales de los procedimientos a las que se invoca después de crear un hilo.
Estado: distintos hilos pueden estar en ejecución, listos o bloqueados esperando un evento.
PROCESOS v/s HILOS
Semejanzas: Los hilos operan, en muchos sentidos, igual que los procesos.
Pueden estar en uno o varios estados: listo, bloqueado, en ejecución o terminado.
También comparten la CPU.
Sólo hay un hilo activo (en ejecución) en un instante dado.
Un hilo dentro de un proceso se ejecuta secuencialmente.
Cada hilo tiene su propia pila y contador de programa.
Pueden crear sus propios hilos hijos.
Diferencias: Los hilos, a diferencia de los procesos, no son independientes entre sí.
Como todos los hilos pueden acceder a todas las direcciones de la tarea, un hilo puede leer la pila de cualquier otro hilo o escribir sobre ella. Aunque pueda parecer lo contrario la protección no es necesaria ya que el diseño de una tarea con múltiples hilos tiene que ser un usuario único.
Ventajas: de los hilos sobre los procesos.
Se tarda mucho menos tiempo en crear un nuevo hilo en un proceso existente que en crear un nuevo proceso.
Se tarda mucho menos tiempo en terminar un hilo que un proceso.
Se tarda mucho menos tiempo en conmutar entre hilos de un mismo proceso que entre procesos.
Los hilos hacen más rápida la comunicación entre procesos, ya que al compartir memoria y recursos, se pueden comunicar entre sí sin invocar el núcleo del SO.
Ejemplos de uso de los hilos:
Trabajo interactivo y en segundo plano: En un programa de hoja de cálculo, un hilo podría estar leyendo la entrada del usuario y otro podría estar ejecutando las órdenes y actualizando la información.
Procesamiento asíncrono: Se podría implementar, con el fin de protegerse de cortes de energía, un hilo que se encargará de salvaguardar el buffer de un procesador de textos una vez por minuto.
Estructuración modular de los programas: Los programas que realizan una variedad de actividades se pueden diseñar e implementar mediante hilos.
El
proceso de arranque del núcleo Linux tiene básicamente la misma distribución jerárquica en cuanto al proceso que se ejecuta después del
arranque e inicialización del núcleo que los Unixes convencionales, lo
que sera descrito a continuación es una descripción de los entresijos
que ocurren durante esa etapa de inicialización.
Desde su primera versión y al ser un OS tipo Unix cuando el kernel 'termina' su ejecución (realmente no lo hace, solo cede el control a un proceso padre
[init] aunque continuara ejecutandose, planificando procesos, etc) hace
una búsqueda de un programa llamado init.
Windows
Uno de los procesos mas ocultos que existe en un sistema operativo gráfico
como Windows XP, es el proceso de inicio del sistema o BOOTING; este
proceso es además de todo un proceso critico en el sistema, dado que en
el se define el comportamiento posterior del sistema. Inicializar el
sistema cuando se prende un equipo es un proceso directo para la
mayoría de los usuarios, pero cuando se habla de administración se debe
conocer este proceso en detalle para poder resolver muchos de los
problemas relacionados con el arranque y configuración de dispositivos.
Cómo matar procesos en Windows y Linux desde la consola:
Linux
Escribimos primero ps -aux para obtener una lista de los procesos que se están ejecutando y su pid correspondiente (segunda columna), después kill pid_del_proceso para matar el proceso o kill -9 pid_del_proceso para obligar al sistema operativo a matar el proceso.
Otra opción es killall nombre_programa que matará todos los procesos que estén ejecutando ese programa.
Por último pkill criterio utiliza grep para buscar todos
los procesos que coincidan con el criterio especificado y les manda la
señal SIGTERM. Por ejemplo pkill fire mataría tanto el proceso firefox como el proceso firebird, dado que la cadena fire aparece en ambos.
Windows
Si conocemos el pid
del proceso que queremos matar, por ejemplo vía el administrador de
tareas (ver -> seleccionar columnas -> Identificador de proceso
(PID)) o cualquier otro programa externo basta escribir en la línea de
comandos o en inicio->ejecutar ntsd -p pid_del_proceso -c "q"